纸质发票、扫描合同不用再手打了:MiniCPM-OCR 开源,1.3B 小模型专做文档解析
一叠扫描合同、一堆拍歪了的发票照片,要变成能搜索、能复制的文字,过去要么人工一页页敲,要么先修图再识别,错了还得逐页对。10 月 31 日,ModelBest 与 OpenBMB 联合开源了 MiniCPM-OCR 系列,专门冲着这个活儿来:一个负责把文档认出来,一个负责当“质检员”,替你把认错的地方挑出来。
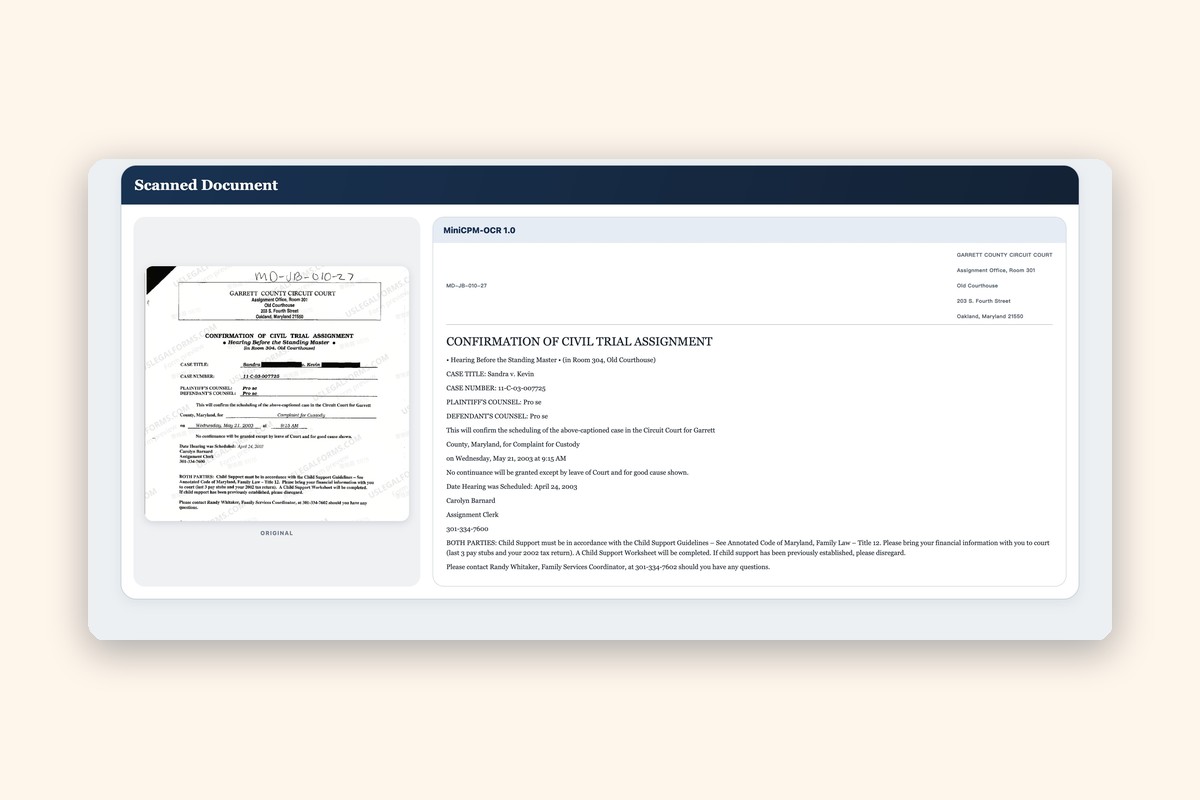
对谁有用
最直接的受益者,是手头有大量纸质或图片文档要数字化的人:财务对账的发票、合同档案、图书馆的扫描件、学校的历史试卷。官方介绍里点名的场景也正是这些:金融合同档案、学术图书馆、政府记录,一次处理几百万页的量级。对普通读者来说,这不是一个装完就能点的手机 App,而是一套给开发者和团队用的开源模型——如果你只是偶尔要认几页纸,先用手机扫描或本站的 PDF 合并教程里提到的本地工具处理,犯不着为它搭一套系统。
有什么变化
这次一共开源了两个模型。MiniCPM-OCR 1.0 只有 13 亿参数,是 MiniCPM 家族里第一个专门做 OCR 的模型,官方称它在保持小体积、适合边缘设备部署的同时,解析精度达到了同类开源模型的前列。它号称不用繁琐的图像预校正,就能处理扫描件、实拍照片、弯曲、倾斜和截屏文档;中英双语密集排版、复杂数学公式、多级或无边框表格都在它的覆盖范围里;除了整页重建,还能按业务指令从发票、证件、财务报表里抽取指定字段。
另一个模型 MiniCPM-OCR Jev 只有 20 亿参数,本身不做识别,专门做判断:它把源图和 OCR 结果放在一起比对,给文字、LaTeX 公式和表格打可信度分数,找出缺字、错字和排版错位。官方称它的判断精度接近大得多的模型。关键在于它可以跨模型部署,不用换掉你现有的识别引擎:结果可靠的直接走流程,可疑的挑出来人工复核,多个识别系统出不同结果时,还能帮你选出最好的那一个。也就是说,质检从“逐页人工看”变成了“只看被标记的那几页”。
部署层面,这套模型已上架 GitHub、Hugging Face 与 ModelScope,支持 vLLM、SGLang、llama.cpp 和 Ollama,并提供 SDK、API、Agent Skill 插件与开源微调代码。官方还提到 DSpark 解码加速能提升整页处理速度、降低单页延迟——这是厂商的说法,本站没有实测,实际效果要以你自己的文档和硬件为准。
站长判断:OCR 这件事,难的从来不是“认出一页”,而是“认错了你还不知道”。MiniCPM-OCR 有意思的地方不在 1.3B 这个数字本身,而在它把“质检”单独做成了一个模型:对要批量处理文档的团队来说,省下的不是识别时间,而是复核时间。普通用户不用追这个版本,等它被装进扫描、归档类工具里再用也不迟;有现成流程的团队,可以先拿自己最难的那类文档(比如手写批注多的、表格线断掉的)做一轮小样本对照,再决定要不要换。
读者下一步能做什么
如果你是开发者或负责文档数字化的团队,可以去 GitHub、Hugging Face 或 ModelScope 上找 MiniCPM-OCR 系列,先用自己的样本测精度和质检命中率,再谈替换现有流程;如果你只是偶尔处理几份文件,继续用现成的扫描与 PDF 工具就好,模型本身不是给你直接用的成品。想了解同类开源 AI 模型的路子,可以看看本站之前写的 DeepSeek DeepInfer 开源解析。
相关阅读
- DeepSeek 把“上菜的机器”开源了:DeepInfer 意味着什么
- PDF 合并:多个 PDF 合成一个,用本站工具本地完成,不上传不加水印
- PDF 拆分:把一个 PDF 按页拆开,抽取指定页面另存新文件
信息来源:ModelBest / OpenBMB 官方公告(2026-10-31);文中判断为本站观点,配图为写实风格概念图,非官方截图。
发表评论